Wer hat was gesagt, und warum mein Laptop es ständig falsch wusste
Sprecher in einem Call zu erkennen, klingt nach gelöstem Problem, bis du die Kopfhörer absetzt. Eine Woche mit Echo, vertauschten Namen, einem Fix, der mich für meine Kollegen stummgeschaltet hat, und was Meetre jetzt macht.
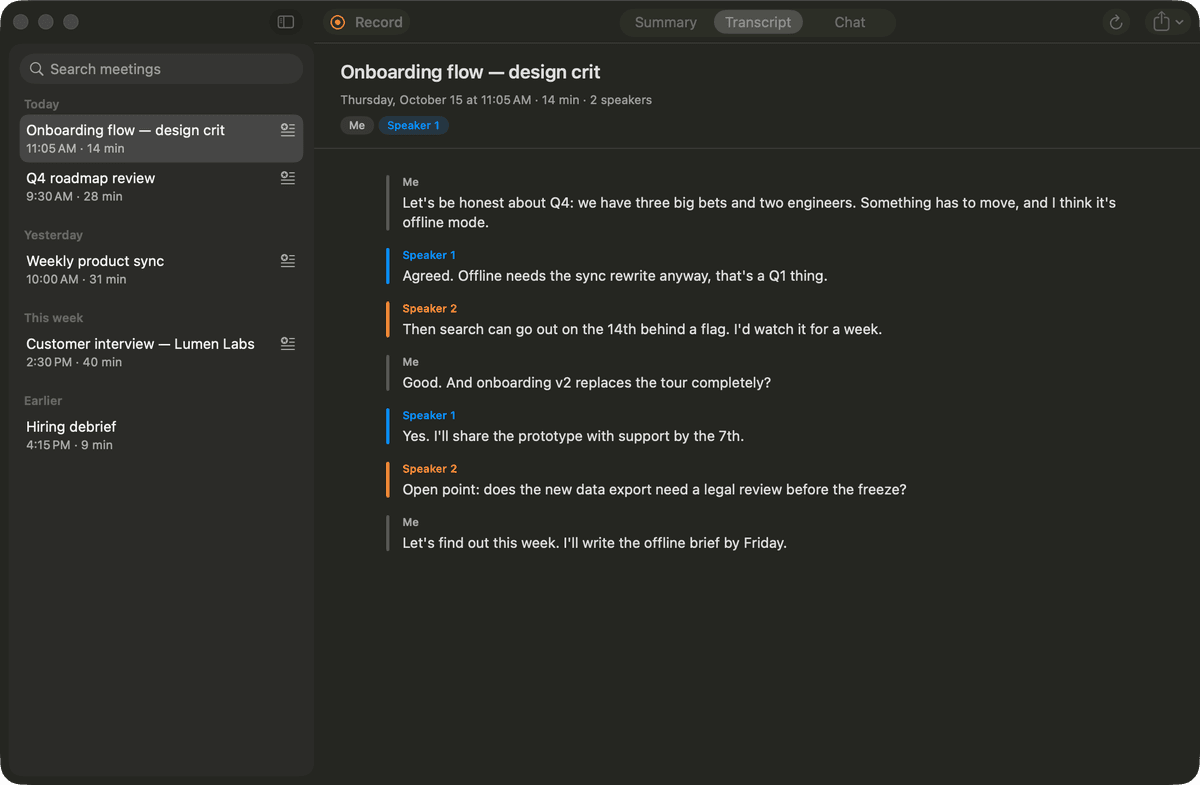
Der Bugreport kam von mir selbst. Ich hab mein eigenes Transkript gelesen und festgestellt, dass ich offenbar den halben Text meines Kollegen gesagt habe. Sehr überzeugt. Mit Zeitstempeln.
Meetre nimmt in einem Call zwei Spuren auf: dein Mikrofon und den Systemton, getrennt voneinander. Darauf basiert die ganze Sprechererkennung. Kommt etwas aus der Mikrofonspur, bist du das. Kommt es aus der Systemspur, ist es die Gegenseite. Danach trennt pyannote die einzelnen Stimmen innerhalb jeder Seite. Auf dem Papier sehr ordentlich. Mit Kopfhörern auch. Der Ärger fing an dem Tag an, an dem ich sie abgesetzt hab.
Deine Lautsprecher sind ein zweites Mikrofon
Ohne Kopfhörer kommt der Call aus den Laptop-Lautsprechern, und dein Mikrofon hört mit. Einen Moment später, etwas leiser, mit etwas Raumhall, aber eindeutig da. Die Mikrofonspur bist also nicht mehr nur du. Sie ist du plus eine verzögerte Kopie von allen anderen.
Die alte Zuordnung hat jedes Segment am Stück entschieden, indem sie die rohe Lautstärke vom Mikrofon mit der vom Systemton verglichen hat. Das geht auf zwei Arten schief. Ein Satz, den ich anfange und mein Gegenüber beendet, bekommt ein einziges Label für beide. Und wenn das Echo im Mikrofon lauter ist als der Call in der Systemspur, was von deiner Lautstärke und deinem Pegel abhängt, kippen die Labels. So hab ich Dinge gesagt, die ich nie gesagt hab.
Wort für Wort
Der erste echte Fix: nicht mehr pro Segment entscheiden. Die neue Zuordnung schaut sich die Aktivität pro Frame an, gemessen am Grundrauschen der jeweiligen Spur statt an der rohen Lautstärke. Sie schätzt aus Momenten, in denen nur der Call läuft, wie viel davon ins Mikrofon rüberblutet, zieht das ab und stimmt dann pro Wort ab, mit etwas Glättung. Wo die Seite wechselt, wird das Segment geteilt. Parakeet liefert Wortteile statt ganzer Wörter, die mussten vorher erst zu Wörtern mit Zeitstempel zusammengesetzt werden.
Damit ich nicht vierzig Takes mit einem Freund aufnehmen muss, hab ich einen synthetischen Call gebaut: Sprachausgabe statt echter Stimmen, keine Pausen dazwischen, leises Mikro, lautes Echo. Im Grunde das schlimmste Meeting, das mir eingefallen ist. Die alte Logik hat 39 von 41 Sätzen richtig zugeordnet. Die neue 41 von 41.
Im selben Zug hab ich noch eine kleinere Nervigkeit erledigt. Die Diarisierung hat manchmal aus einem Husten und einer Tür einen Sprecher 2 erfunden. Cluster, die nur einen kleinen Anteil der Sprache einer Seite ausmachen, werden jetzt der Hauptstimme zugeschlagen, statt als Phantom-Teilnehmer aufzutauchen.
Dann haben die Live-Untertitel alles schlimmer gemacht
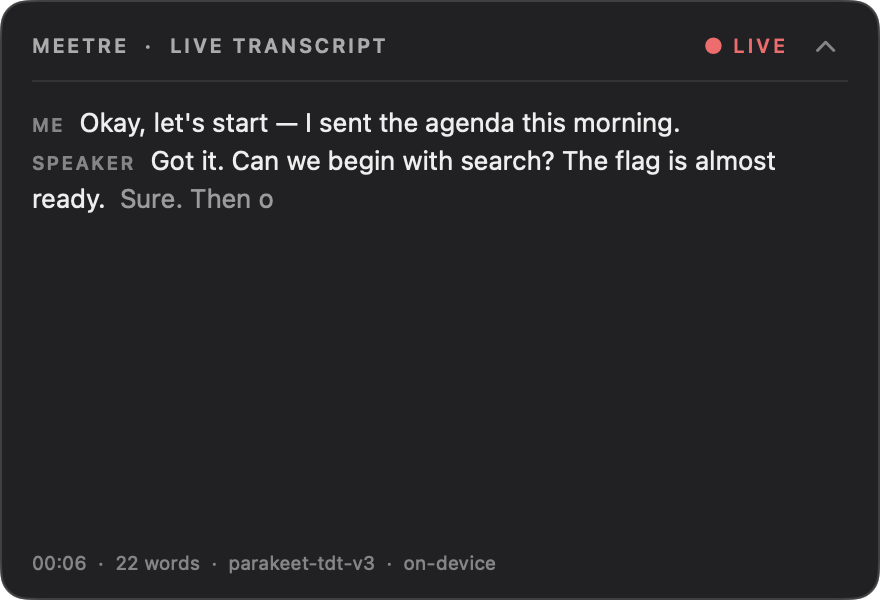
Das fertige Transkript hat Zeit zum Nachdenken. Live-Untertitel nicht. Sie dekodieren etwa alle 0,6 Sekunden ein kurzes Stück Audio neu, und zwar die Summe aus beiden Spuren. Mit Lautsprechern war jeder Satz der Gegenseite also zweimal drin, leicht versetzt. Parakeet hat gemacht, was jeder Mensch mit zwei überlappenden Kopien desselben Satzes machen würde: Kauderwelsch draus oder gar nichts.
Mein erster Versuch war eine eigene Echo-Unterdrückung. Die Lautstärkeverläufe beider Spuren gegeneinander verschieben, um die Verzögerung vom Lautsprecher zum Mikro zu schätzen, den Echo-Pegel lernen, Mikro-Frames stummschalten, in denen nur Echo steckt, und meine eigene Stimme drinlassen, auch wenn ich jemandem reinrede. Auf meinem Schreibtisch hat das funktioniert. Bei echter Lautstärke nicht. Ich hab's wieder gelöscht.
Der Fix, der mich stummgeschaltet hat
Zweiter Versuch: Apples eigene Echo-Unterdrückung. macOS hat Voice Processing direkt in der Audio-Engine, dasselbe, womit FaceTime ohne Kopfhörer funktioniert. Ich hab das Mikro da durchgeschickt, und das Ergebnis war ehrlich gesagt perfekt. Das rohe Mikro hat die Sätze der Gegenseite Wort für Wort mittranskribiert, das bearbeitete Mikro hat davon nichts übrig gelassen.
Morgens ausgeliefert. Nachmittags hatte ich gemessen, was es mit allem anderen anstellt. Solange das Voice-Processing-Mikro von Meetre läuft, hört jede andere App dein Mikrofon etwa 35 dB leiser. Meine Kollegen in Teams konnten mich kaum noch verstehen. Der Ton vom Call selbst wurde um etwa 8 dB abgesenkt, auch mit ausgeschalteter Pegelautomatik und minimalem Ducking. Nichts davon lässt sich von meiner Seite der Schnittstelle reparieren.
Ein Aufnahme-Tool, das dich im Meeting unhörbar macht, das es gerade aufnimmt, hat Datenschutz in einem sehr engen technischen Sinn gelöst.
Voice Processing ist deshalb jetzt optional, standardmäßig aus, mit dem Hinweis, dass man es in Calls besser nicht anschaltet.
Was wirklich funktioniert
Die Lösung, die geblieben ist, ist weniger clever. Die Live-Untertitel transkribieren Systemton und Mikrofon als zwei getrennte Streams und sortieren die Zeilen nach Zeit zusammen. Wer spricht, ergibt sich schlicht aus der Quelle. Wenn zwei Leute gleichzeitig reden, wird daraus kein Brei mehr. Der Mikro-Stream wird nur dort dekodiert, wo eine Spracherkennung (Silero VAD) tatsächlich Sprache findet, und Mikro-Zeilen, die wiederholen, was im Call gerade gesagt wurde, fliegen als Echo raus. Getestet mit Lautsprechern bei normaler Lautstärke: keine Echo-Zeilen.
Dann noch ein Bug, auf den ich nie gekommen wäre. ScreenCaptureKit, worüber der Systemton reinkommt, hört auf, wenn der Bildschirm in den Ruhezustand geht. Standard sind zwei Minuten. Wenn du in einem langen Call nur zuhörst und nichts anfasst, dimmt der Bildschirm, schläft ein, und die andere Seite des Meetings wird ganz leise nicht mehr aufgenommen. Meetre hält den Bildschirm jetzt wach, solange es aufnimmt.
Tempo als Trostpreis
Eine Sache in dieser ganzen Geschichte lief einfach gut. Die Diarisierung lief früher auf der CPU. Seit die pyannote-Pipeline auf Metal (MPS) läuft und pro Prozess im Speicher bleibt, dauern zehn Minuten Audio auf einem M5 Pro etwa 23 statt etwa 275 Sekunden. Wenn auf MPS etwas schiefgeht, fällt sie auf die CPU zurück. Und das Transkript erscheint jetzt, sobald die Transkription fertig ist, und aktualisiert sich dann, wenn Sprecher und Zusammenfassung so weit sind. Du starrst für die langsamen Teile also nicht mehr auf einen Spinner.
Alles steht im Repo, inklusive des Commits, in dem ich meine eigene Echo-Unterdrückung zwei Tage nach dem Schreiben wieder rausgeworfen hab. Ich trag inzwischen eh wieder Kopfhörer.